Summary
ひと目でわかる要約
- 警告がないこととセキュリティログが正常に収集されたことは別なので、収集パイプライン自体の可観測性が必要です。
- Google SecOpsはpush・pull Feedの欠落・遅延・失敗を確認し、FeedやCollectorごとに調査を絞れます。
- 実務ではheartbeat、最終正常受信時刻、遅延、失敗・再試行、原本と収集量の差を基本指標にします。
資料基準:Google Cloud公式文書、最終更新2026年7月26日
私はしばらく、セキュリティ画面に警告がなければ静かな一日だと思っていた。問題は、ログ収集器が止まってもダッシュボードは驚くほど落ち着いていられることだ。誰も出勤していないオフィスから「会議は平和でした」と報告したようなものだった。
Google SecOpsの最近の文書は、この穴を理解するよい例だ。AI検知モデルより前に、ログの収集過程も状態を残す必要がある。
1. データが通る道を分ける
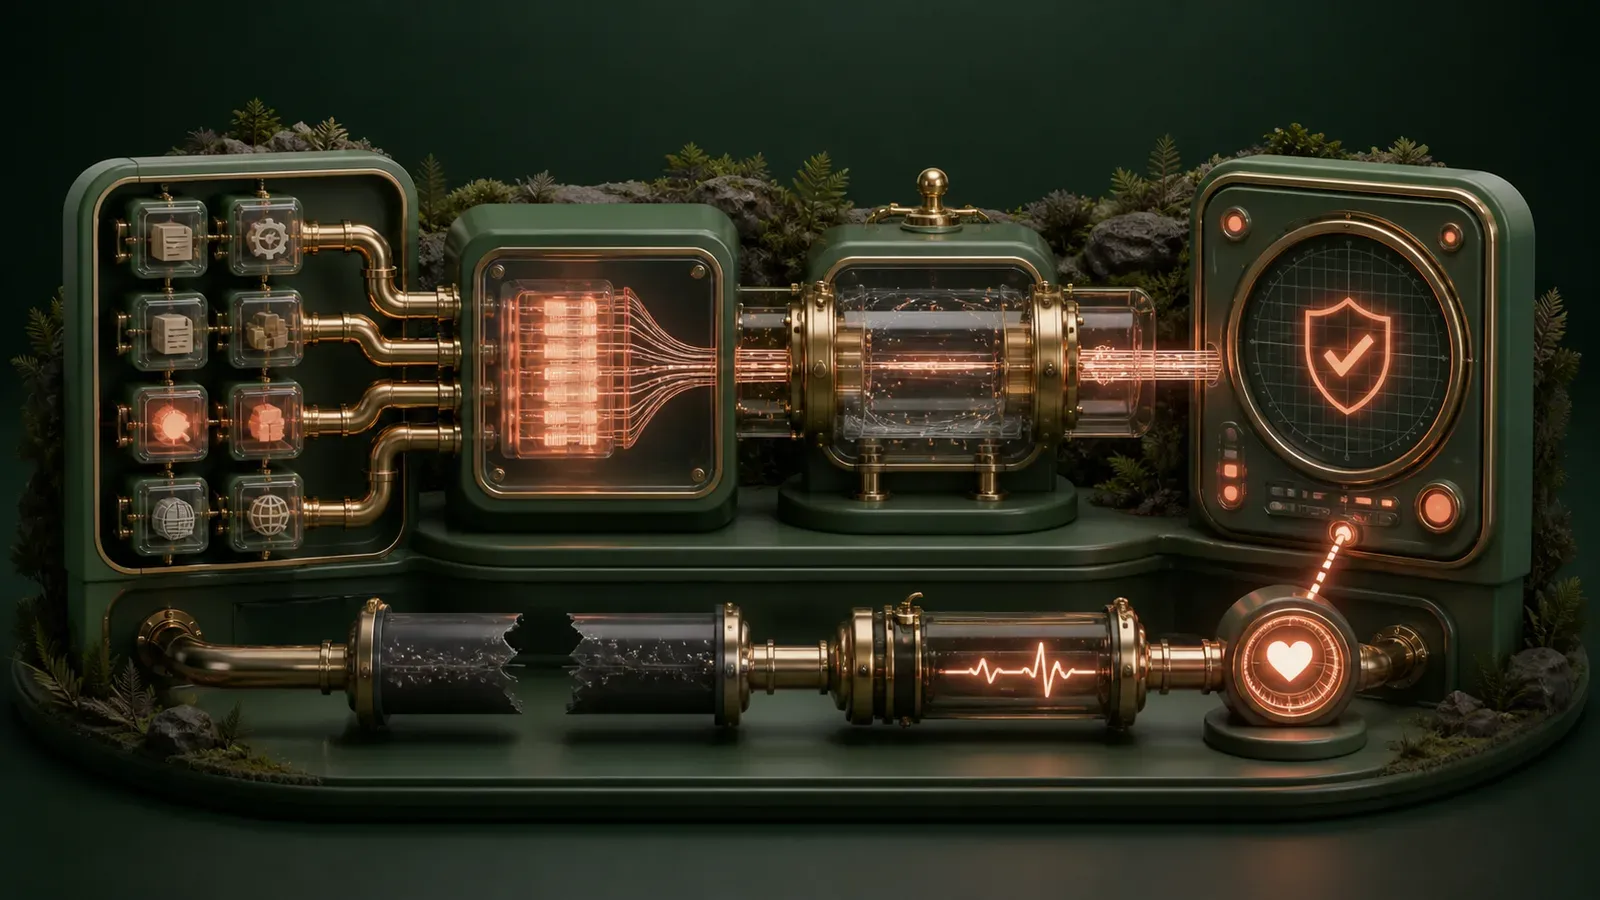
セキュリティログは、おおよそ次の道を通る。
元システム → CollectorまたはFeed → 収集パイプライン → SIEM保存 → 検知ルール
最後が0件でも、原因はいくつもある。
- 本当に不審な動きがなかった。
- 元システムがログを作れなかった。
- Collectorが止まった。
- 転送が遅れた、または失敗した。
- SIEMには届いたがルールが見逃した。
前半が見えなければ、平和と故障した管を区別できない。
2. Google SecOpsで見えるもの
Public Preview機能はSecOpsの収集とFeed活動ログをCloud Loggingへ送る。Googleによるとpushとpullの双方に対応し、欠落・遅延・失敗したログの調査に使える。
feed_idやcollector_idで範囲を絞れ、Feed画面のDebug with logsから事前フィルター済みのLogs Explorerを開ける。Gemini Cloud Assistも同じログ・メトリクスの分析に接続できる。
ここでAIは助手であって配管工ではない。ネットワーク権限や収集設定が間違っていると、きれいな説明で障害報告書の文章だけが良くなり、管は詰まったままだ。
出典:Google CloudのSecOps収集活動分析文書、Google SecOpsリリース情報
3. 私が標準で残す指標
この原則は一般的なアプリケーションログにも使える。私はイベント本体とは別に次の五つを残す。
- Heartbeat: 収集器が生きていることを示す定期信号
- 最終正常受信時刻: いつから切れたか
- 転送遅延: 生成時刻と到着時刻の差
- 失敗・再試行数: 静かな消失の手がかり
- 元データ対収集量: 通常の基準線から急減していないか
通知も、セキュリティ事件と収集パイプライン障害の二層に分ける。火災報知器と電池切れ警告は別の問題を解く。電池警告を無視すると、次の通知は近所の人がドアをたたく方式で来るかもしれない。
4. Public Previewという境界
これはPre-GA機能だ。正式提供機能と同じ安定性を前提にしない。運用へ入れるなら次を記録する。
- 対応範囲と既知の制限
- ログ保存期間と費用
- Feed・Collector識別子の管理方法
- Preview変更時の代替照会手順
- Geminiの提案と人が実際に適用した措置の区別
新機能を有効にした事実より、その機能が変わっても障害を探せることの方が重要だ。
私の結論
ログがないこと自体も観測すべき状態だ。 入力が消えれば、どれほど賢いモデルにも材料がない。検知精度を聞く前に、私は「今日、ログは全員出勤したか」と確認したい。出席簿がセキュリティ戦略になるとは思わなかったが、運用はしばしば一番普通の質問で生き残る。
反応を残すと、重複防止のためランダムな識別子がこのブラウザーに保存される場合があります。