Summary
ひと目でわかる要約
- AI Gatewayは、複数のAIモデルへのリクエストを一か所で確認し、管理するための窓口だ。
- 利用量を見るだけでなく、APIキーごとに使える金額を決めておくと安心できる。
- モデル名より先に、費用、応答の速さ、処理量のどれを重視するか決める。
AIにもう一つ仕事を頼もうとして、先に費用が気になった。一回のリクエストは安く見える。でも、自動処理が同じミスを一晩中くり返したら話は別だ。
そこでVercelの公式発表を読み直した。AI Gatewayは、複数のAIモデルへのリクエストを一か所で確認し、管理するための窓口と考えると分かりやすい。私が覚えておきたい点は四つだった。
まず、どこで使ったかを見る
VercelのAI Gateway正式リリースには、費用と利用量を確認でき、ある事業者に障害があれば別の事業者へ切り替えられるとある。
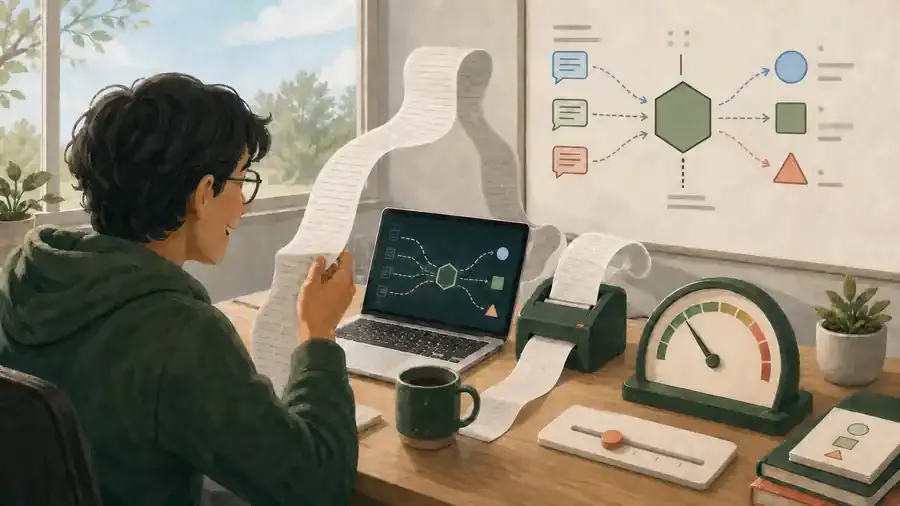
レシートがあるだけで節約できるわけではない。それでも、どのリクエストが長く動き、どれだけトークンを使い、どこで費用が増えたかは分かる。「今月は何となく高い」より、ずっと役に立つ。
ミスより先に上限を置く
APIキーごとの予算では、キーごとに金額の上限と更新周期を設定できる。上限まで使うとリクエストは止まる。
私は月末のきれいな報告書より、こちらを重く見たい。報告書はお金が出た後に届く。上限はミスが小さいうちに止めてくれる。自動処理で怖いのは、一度の失敗より、同じ失敗を休まず続けることだ。
お気に入りより基準を選ぶ
プロバイダーの並べ替えでは、費用、最初の応答までの時間、処理量を基準に順番を決められる。いつも最安が正解とは限らない。下書きは費用、会話は応答の速さ、長い処理は処理量が大切かもしれない。
ルーティング規則を使うと、アプリのコードを直さずに、特定モデルへのリクエストを別のモデルへ変えたり拒否したりできる。ただし、切り替えたモデルが自動的に良い結果を出すわけではない。品質、速さ、費用はもう一度確かめる。
頭の中で試した三つの場面
以下は実際の事故ではなく、機能を理解するための想像だ。
- AIが自分の要約を何度も要約する。答えは短くなるのに、レシートだけが紙のロールのように伸びる。予算の上限が先に止めてくれた。
- 朝は速い事業者が一位で、午後は安い事業者が一位になる。私がファンクラブを替える必要はない。仕事の基準を決めればいい。
- 古いコードが引退したモデルを呼び続ける。ルーティング規則で確認済みの代わりへ送り、準備ができていなければはっきり拒否する。
私が決めた順番は単純だ。
- リクエスト数と費用を見えるようにする。
- 仕事ごとにキーを分け、払える上限を置く。
- 費用、応答の速さ、処理量から一つの基準を選ぶ。
- モデルを変えたら、代表的な仕事でもう一度試す。
AIに仕事を増やす前に、カードの上限を決める。少し慎重に見えても、運用はそのほうが長く続く。
反応を残すと、重複防止のためランダムな識別子がこのブラウザーに保存される場合があります。